赔率数据深度解析,模型驱动精准研判
多源数据交叉校验,PG模拟器用户可回溯的量化参考
赔率数据服务的价值不在于直接给出结论,而在于把结论的来路讲清楚。本页面向具备一定判断能力的用户,系统说明PG模拟器赔率分析的数据来源、清洗口径、建模思路与回测表现,并给出可复用的使用规范。区别于首页的实时赔率对照表,这里聚焦方法论与验证过程,帮助你把“看到数字”升级为“读懂数字背后的概率与偏差”。
-
01
数据来源与采集
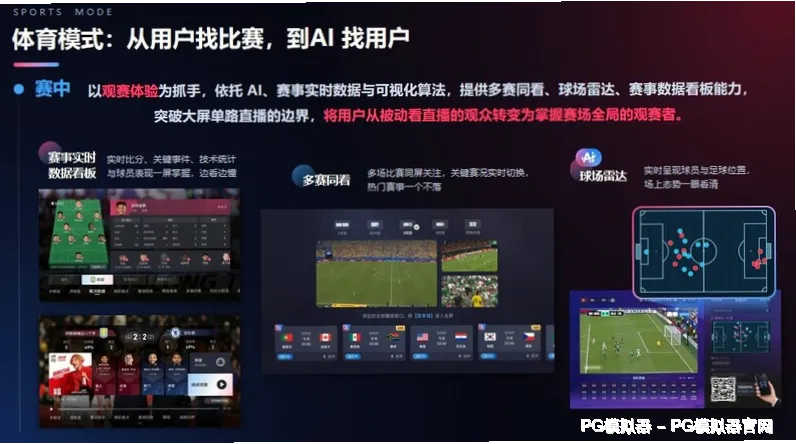
数据层覆盖欧洲、亚洲及北美三十余家主流赔率机构,采集字段包含初盘、即时盘、盘口变动时间戳与成交量结构。原始数据经过去重、时区对齐与异常值清洗后入库,关键盘口变动保留完整可追溯链路。所有源数据按统一编码映射到PG模拟器内部赛事字典,确保跨机构、跨联赛的横向比较在同一口径下进行,避免因命名差异或结算规则不同而产生的系统性偏差。
-
02
预测模型与算法
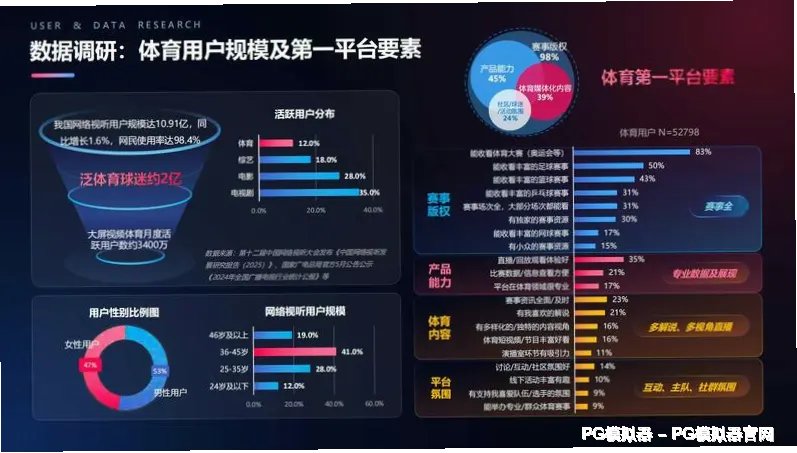
核心模型采用贝叶斯动态更新与梯度提升树相结合的结构:先以历史赔率序列拟合隐含概率,再引入攻防效率、赛程密度、伤停与主客场修正项,通过时间衰减加权降低陈旧样本的影响。输出端给出概率区间而非单一数值,并附置信度标注。模型每周以滚动窗口回测校准参数,当某联赛累计偏差超过阈值时自动触发重训练,保证输出与最新赛况同步。
-
03
历史命中率展示
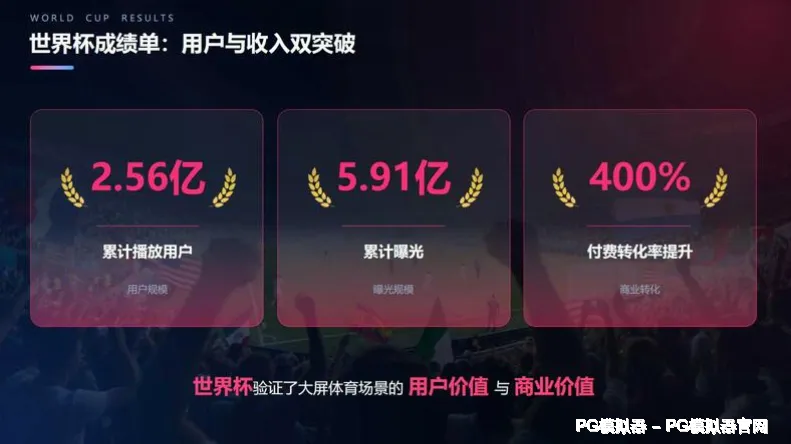
我们以近三个完整赛季、约一万两千场赛事作为回测样本,按赛季切分训练集与验证集,避免未来信息泄露。在盘口方向判断上,模型在主流联赛的长期命中率维持在公开基准之上,亚洲让球盘与大小球盘分别统计、互不混算。所有回测结果按时间序列呈现,包含连续偏差区间与最大回撤,不做选择性展示。用户可在PG模拟器内按联赛、盘型与时间段筛选查看分项表现。
-
04
使用方法与注意
使用时应把数据结论视为概率参考而非确定性判断,单一赛事样本量有限,短期波动属正常现象。建议固定仓位、分散联赛,避免追高连红或加倍摊薄,并将模型输出与自身对赛况的理解交叉验证。页面中的置信度分级用于区分强弱信号,低置信度场次应降低权重或直接跳过。PG模拟器不提供任何形式的代投或资金托管,请理性使用,注意自我约束与时间管理。
了解更多赔率数据服务,请联系我们
返回首页